
한 번 보여주면 배우는 로봇 AI 마첸타, 4천만 달러 시드 투자유치


로봇에게 새 일을 가르치는 데는 여전히 며칠이 걸린다. 사람이 같은 작업을 수십, 수백 번 시연해 데이터를 모으고, 이를 모델에 다시 학습시켜야 한다. 이 과정을 거쳐도 로봇은 배운 일만 할 수 있어서, 새 기술이 필요하면 개발자가 모델을 고쳐야 한다. 로봇 파운데이션 모델에 수십억 달러가 몰리는 와중에도 병목은 ‘가르치는 비용’에 남아 있다.
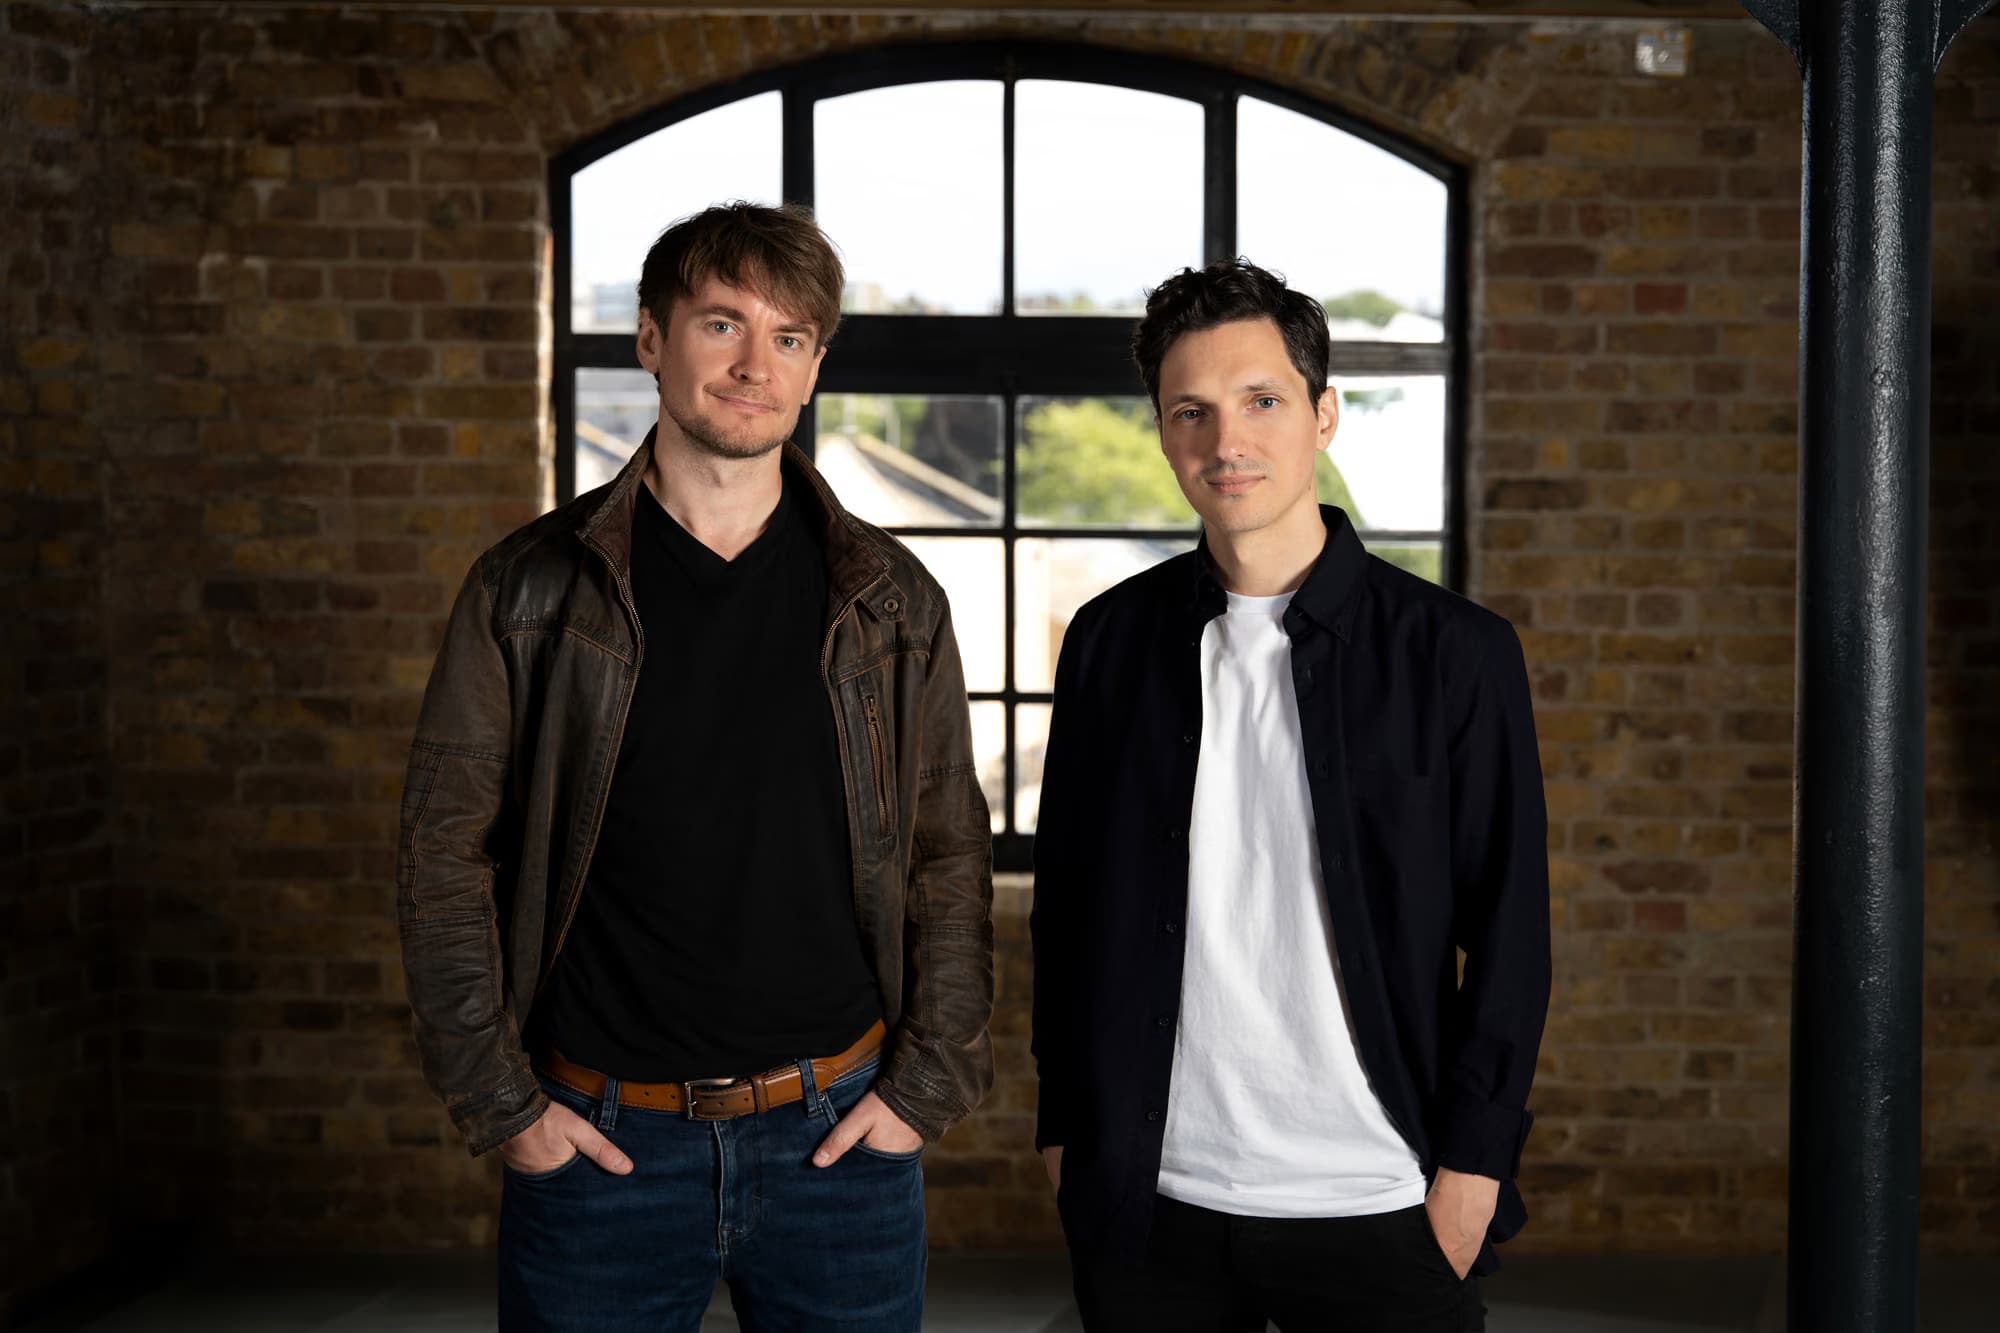
영국 임페리얼 칼리지 런던(Imperial College London)의 스핀아웃 마첸타(Machenta)는 이 병목을 “시연 한 번”으로 풀겠다는 회사다. 크레안덤(Creandum)과 유니언스퀘어벤처스(Union Square Ventures)가 공동 주도한 시드 라운드에서 4천만 달러를 투자유치했다고 발표했다. 회사는 영국 로보틱스 스타트업 역대 최대 규모의 시드라고 밝혔다. 기업가치와 다른 참여 투자사는 공개되지 않았다. 호스턴 벤처스(Hoxton Ventures)도 창업 첫해인 2025년 투자자로 이름을 올리고 있다.
언어 대신 시연을 입력으로 받는 모델
마첸타가 만드는 것은 비전-시연-액션(VDA, vision-demo-action) 모델이다. 로봇 업계의 주류인 VLA(비전-언어-액션) 모델이 “컵을 선반에 올려”처럼 언어 지시로 작업을 정하는 것과 달리, VDA는 카메라 영상과 사람이 한 번 보여준 시연을 함께 입력받아 로봇의 동작을 실시간으로 내놓는다. 회사는 이를 ‘인스턴트 로봇 러닝’이라 부른다. 사람이 로봇 팔을 직접 움직이거나 VR 컨트롤러, 리더-팔로워 장비, 심지어 맨손 시범으로도 가르칠 수 있고, 가르친 뒤에는 추가 학습 없이 바로 수행한다.
핵심은 사전학습 방식이다. 지금의 로봇 AI는 실제 세계에서 모은 방대한 시연 데이터, 특히 사람이 직접 로봇을 조종해 얻은 데이터로 사전학습하는 경우가 많다. 마첸타의 모델은 시뮬레이션 데이터만으로 사전학습한다. 물체, 작업, 배치, 환경, 로봇 형태를 무작위로 바꿔 가며 만든 가상 경험으로 “새 작업을 배우는 법”을 익히게 하고, 실제 세계의 데이터는 현장에서 보여주는 시연 단 한 번에만 쓴다. 대규모 인간 데이터를 확보하는 비용과 프라이버시 부담에서 벗어날 수 있다는 것이 회사 주장이다.
회사가 공개한 수치는 초기 단계다. 스스로 초기화되는 단순 과제를 한 시간 동안 연속으로 돌린 시험에서 블록을 그릇에 담는 작업은 74번 중 74번, 드라이버를 주고받는 작업은 78번 중 78번 성공했고, 병을 세우는 작업은 99번 중 97번 성공했다. 실패 두 번은 충돌 위험과 로봇 관절 제약 때문이었다고 한다. 서로 다른 카메라 구성을 가진 로봇 6종이 같은 모델로 작동했고, 종이롤 교체와 공구함 정리, 케이블 분류, 포장기 투입 같은 작업도 시연했다. 휴머노이드와 사람 손을 보고 배우는 기능은 아직 예비 단계다.
6년 연구의 상업화, 크레안덤·USV가 베팅
마첸타의 뿌리는 6년 전 임페리얼 로봇러닝랩이다. 랩을 이끄는 에드워드 존스(Edward Johns) 교수가 “로봇이 인간만큼 빨리 새 기술을 익힐 수 있을까”라는 질문을 파고들었고, 연구 성과가 가능성을 보이자 박사과정 학생 비탈리스 보실리우스(Vitalis Vosylius)와 랩 동료들이 함께 회사를 세웠다. 존스 교수가 CEO, 보실리우스가 CTO를 맡는다. 두 사람이 ICLR 2025에서 발표한 ‘인스턴트 폴리시(Instant Policy)‘ 논문은 시연 한두 번만으로 추가 학습 없이 새 작업을 수행하는 방법을 제시했는데, 시연·관측·행동을 그래프로 표현하고 확산(diffusion) 모델로 행동을 생성하며 시뮬레이션 데이터로 학습한다. 회사는 이번 모델이 이 논문과 같은 구조인지는 밝히지 않았다.
존스 교수는 지능이 “이미 할 수 있는 일이 아니라 새 일을 얼마나 빨리 배우느냐”의 문제라고 설명했다. 크레안덤의 카티 빌헬름(Kathi Wilhelm) 파트너는 회사가 설립되기 훨씬 전부터 이 문제를 파고들어 온 팀의 실적에 주목했다고 평가했다. 유니언스퀘어벤처스의 레베카 카든(Rebecca Kaden) 매니징 파트너는 인간처럼 빠르게 적응하는 범용 AI가 필요하다는 점을 투자 이유로 들었다. 임페리얼의 메리 라이언(Mary Ryan) 부총장은 영국이 대학의 연구 역량과 산업의 상용화 경로를 결합해 AI 로보틱스의 선두가 될 수 있다고 말했다.
직원은 11~12명 수준이다. 마첸타는 투자금으로 모델을 키우고, 런던 킹스크로스에 새로 낸 사무실 겸 연구실에서 인력을 늘린다. 컴퓨팅 자원과 시뮬레이션 데이터를 더 확보해 더 정밀하고 복잡한 작업을 가르치는 것이 목표다. 가까운 시일 안에 상용화할 계획은 없는 연구 중심 회사다.
경쟁사와 무엇이 다른가
로봇 파운데이션 모델 시장은 이미 거물들이 선점했다. 피지컬 인텔리전스(Physical Intelligence)는 110억 달러 밸류에 10억 달러 투자유치를 협의 중이고, 스킬드 AI(Skild AI)는 14억 달러를 투자유치하며 기업가치 140억 달러를 기록했다. 제너럴리스트(Generalist AI)는 4억 달러 시리즈A로 20억 달러 밸류를 인정받은 뒤 2억 달러를 더 조달했다. 시뮬레이션 쪽에서는 제네시스 AI(Genesis AI)가 1억500만 달러 시드를, 에카로보틱스(Eka Robotics)가 사람 데이터 없이 시뮬레이션에서 학습하는 방식으로 1억5천만 달러 시리즈A를 유치했다.
마첸타가 내세우는 차별점은 세 가지다.
- 새 작업 학습이 시연 한 번에 끝난다. 일반적인 VLA 기반 모델은 사전학습 뒤 작업마다 실제 시연으로 사후학습을 거쳐야 하고, 이 과정이 작업당 수일에서 수주 걸린다는 것이 회사 설명이다. 마첸타는 모델 가중치를 갱신하지 않고 시연을 입력으로 넣는다.
- 실제 세계 데이터를 사전학습에 쓰지 않는다. 피지컬 인텔리전스와 스킬드 AI는 사람이 로봇을 조종해 얻은 시연 데이터가 핵심 자산이고, 제너럴리스트·로다 AI 등도 실제 데이터를 대규모로 모으는 쪽이다. 마첸타는 시뮬레이션에 걸고 실제 데이터는 시연 한 번에만 쓴다. 데이터 수집 인력과 프라이버시 부담이 필요 없고, 회사는 컴퓨팅과 시뮬레이션 데이터를 늘릴수록 한 번에 배울 수 있는 작업의 비율이 높아질 것으로 가정한다.
- 로봇 형태에 묶이지 않는다. 서로 다른 카메라 구성의 로봇 6종이 같은 모델로 움직였다.
같은 ‘시연 학습’ 영역에는 이미 경쟁자가 있다. 제너럴리스트가 지난 8월 공개한 GEN-1.5는 사람이 맨손으로 작업을 한 번 보여주면 평균 59%, 몇 번 더 보여주면 83% 완수율을 보였다. 다만 마첸타는 경쟁 모델과의 비교 벤치마크를 내놓지 않았고, 두 회사의 수치는 과제와 조건이 달라 직접 비교할 수 없다. 마첸타의 신뢰도 시험도 단순한 과제 위주다. 반복 정확도, 실패 복구, 사람 주변에서의 안전, 하드웨어 한계는 아직 검증되지 않았다. 정밀하고 복잡한 동작이 어렵다는 점은 회사도 인정한다. 규모도 11~12명인 마첸타가 80명 안팎(올해 3월 기준)인 피지컬 인텔리전스와 겨루려면, 시뮬레이션 확장이 작업 난이도 상승을 따라가는지가 관건이다.
로봇 산업 전반에 대한 자세한 내용은 여기를 참고하시길.
- Creandum
- funding
- Imperial College London
- Machenta
- Overseas funding
- Physical AI
- robotics
- seed
- Union Square Ventures
기사 공유하기

답글 남기기
댓글을 달기 위해서는 로그인해야합니다.