
맞춤형 AI 추론 인프라 심플리스마트, 1,400만 달러 시리즈B 투자유치


AI 서비스를 실제로 굴리는 단계에서는 모델이 돌아가는지보다 비용을 감당할 수 있는지가 더 큰 문제가 된다. 음성 에이전트는 응답이 늦으면 사용자를 잃고, 야간 문서 처리 작업은 느려도 단가만 낮으면 된다. 같은 모델이라도 워크로드에 따라 필요한 서빙 설정이 달라지는 이유다.
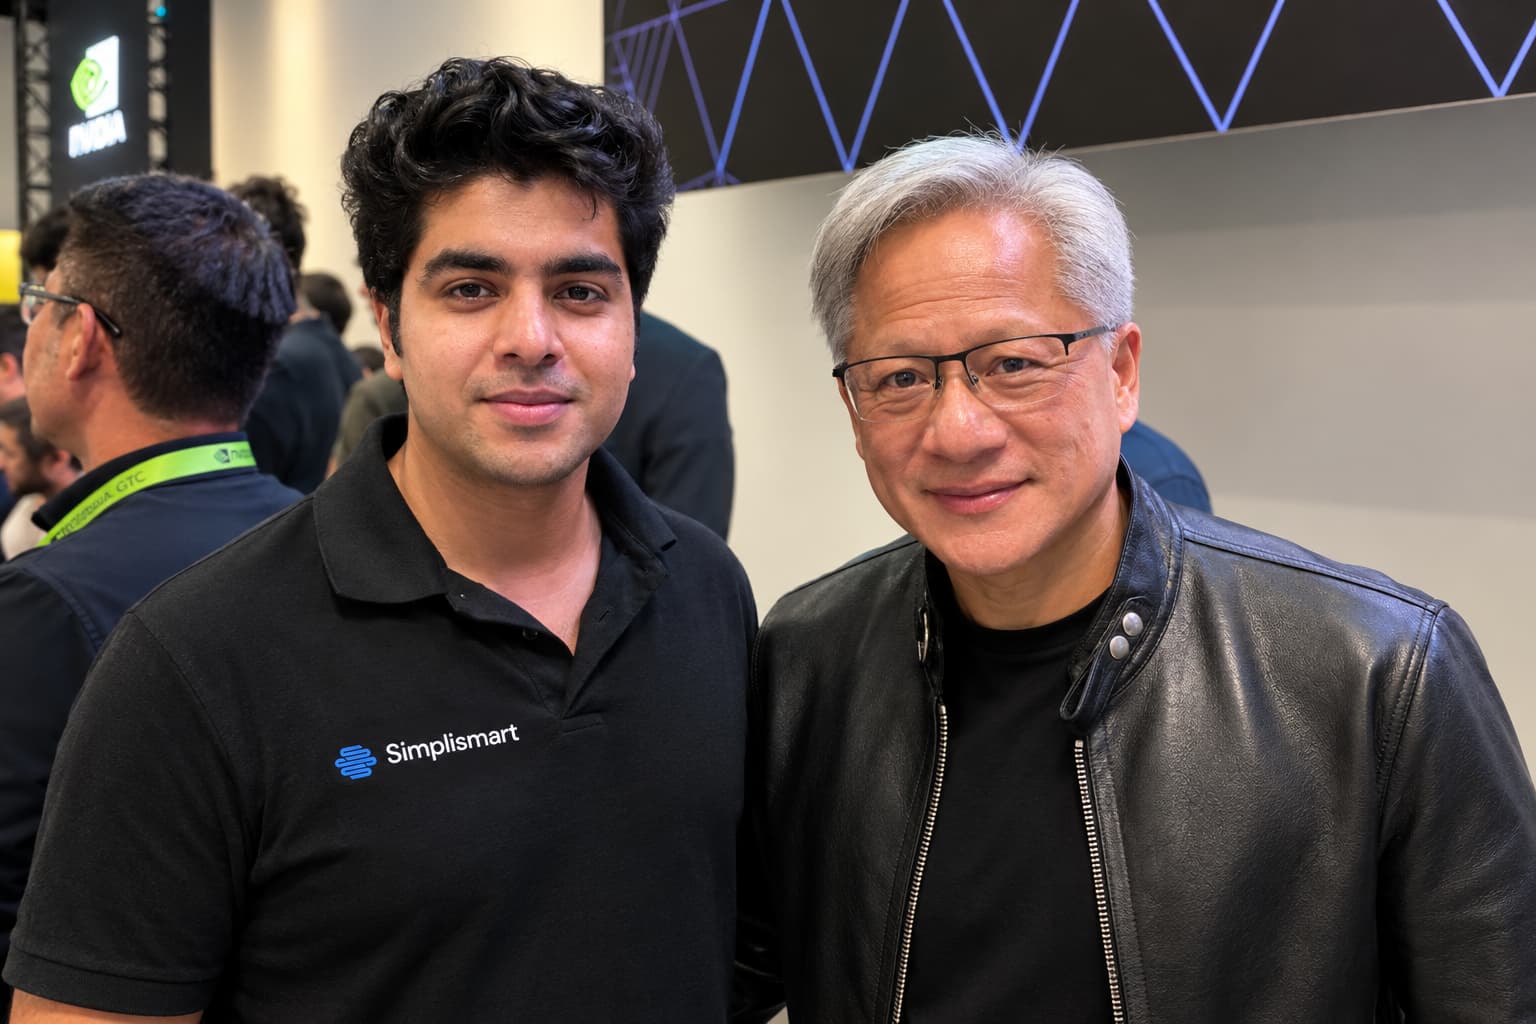
이 문제를 소프트웨어로 풀겠다는 인도 스타트업 심플리스마트(Simplismart)가 1,400만 달러 규모 시리즈B 투자를 발표했다. 댈러스벤처캐피털(Dallas Venture Capital)이 라운드를 주도했고, 엔비디아(NVIDIA), 액셀(Accel), 샤스트라VC(Shastra VC), 마이크로맥스(Micromax)가 참여했다. 기업가치는 공개되지 않았다.
GPU는 직접 짓지 않고, 서빙 소프트웨어를 판다
2022년 아므리탄슈 자인(Amritanshu Jain)과 데반시 가탁(Devansh Ghatak)이 공동 창업한 심플리스마트는 AI 추론 엔진과 오케스트레이션 플랫폼을 만든다. 하드웨어 선택, 정밀도, 배칭, 캐싱, 커널, 스케줄링 등 서빙 스택 전반을 워크로드에 맞춰 구성하고, 트래픽 변화에 따라 GPU 용량을 관리하는 방식이다. 회사는 직접 GPU 인프라를 보유하지 않는다. 서드파티 GPU를 AI 서비스로 바꿔 주는 소프트웨어에 집중한다.
고객은 두 부류다. 애플리케이션 기업은 이 플랫폼으로 자사 제품을 돌리고, 클라우드 사업자는 자체 브랜드의 관리형 AI 서비스를 내놓는다. 인도 클라우드 사업자 요타(Yotta)의 서버리스 추론 서비스 ‘샥티 스튜디오(Shakti Studio)’가 심플리스마트 위에서 돌아간다고 회사는 밝혔다. 직접 쓰는 고객으로는 힉스필드(Higgsfield), 헤이젠(HeyGen), 인비디오(InVideo), 쉽로켓(Shiprocket), 아프나(Apna), 에마(Ema) 등이 꼽힌다.
회사에 따르면 지난 6개월간 연환산 매출(ARR 기준 런레이트)은 14배 늘었다. 절대 금액은 공개하지 않았다.
“추론은 순위표가 아니라 스펙트럼”
회사가 내세우는 논리는 단일 지표 경쟁이 의미 없다는 것이다. 배치를 키우면 처리량은 늘지만 개별 요청은 더 기다리고, 정밀도를 낮추면 연산은 줄지만 품질이 흔들린다.
회사가 든 사례는 고객사 에마다. 목표는 지연 시간 약 200밀리초, 100만 토큰당 약 9센트였다. 한 설정은 5센트였지만 350밀리초가 걸렸고, 다른 설정은 100밀리초에 12센트였다. 심플리스마트는 7센트, 180밀리초의 프로덕션 설정으로 두 조건을 모두 맞췄다고 한다.
음성 에이전트 사례도 제시했다. 엑소텔(Exotel)은 오픈소스 모델을 자사 데이터로 후학습해 심플리스마트에서 돌렸다. 회사가 공개한 비교에서 분당 비용은 0.90~1.30루피로, 폐쇄형 모델 API 구성(2.10루피)보다 약 38~57% 낮았다. 지연 시간은 300밀리초 미만으로, 폐쇄형 구성의 1.1초와 비교됐다. GPU 한 장을 통째로 쓰지 않고 일부만 할당하는 방식이 비용 절감의 핵심이었다. 두 사례 모두 회사가 직접 밝힌 수치다.
“쓸 수 있는 GPU”와 “준비된 GPU”는 다르다
회사는 온디맨드 컴퓨트를 추론 분야의 가장 큰 미해결 과제로 꼽는다. GPU가 비어 있어도 모델이 로드돼 요청을 받을 준비가 된 것은 아니다. 늦게 확장하면 사용자가 기다리고, 피크에 맞춰 용량을 쌓아 두면 트래픽이 줄 때 유휴 GPU 비용을 낸다.
다음 목표는 지역과 시간대를 넘나들며 수요와 용량을 맞추는 동적 스케줄링 계층이다. 점심에 몰리는 소비자 앱과 새벽 2시 배치 작업은 수요가 제각각인데, 클라우드 사업자는 장기 약정으로 GPU를 팔고 고객은 쓴 만큼만 내고 싶어 한다. 이 간극 때문에 한 지역에서는 GPU가 놀고 다른 지역에서는 용량을 못 구하는 일이 생긴다. 다만 응답 시간 요건과 데이터 주권·컴플라이언스 경계를 넘지 않는 범위에서만 용량을 옮길 수 있어야 한다고 회사는 강조했다. 엔비디아 솔루션 아키텍트와의 직접 협업도 이어간다.
조달 자금은 추론 엔진·오케스트레이션 플랫폼 고도화와 클라우드 파트너십 확대에 쓰이고, 북미가 우선 공략 시장이다.
경쟁 구도: 추론 인프라에 수십억 달러가 몰린다
AI 추론 인프라 시장은 이미 대형 딜이 줄을 잇는 격전지다.
베이스텐(Baseten)은 추론 서빙 전문 플랫폼으로, 올해 50억 달러 가치에 3억 달러를 투자유치한 데 이어 130억 달러 가치에 15억 달러 투자유치를 추진 중이라는 보도가 나왔다. 공식 발표 전이다.
파이어웍스AI(Fireworks AI)는 오픈모델 추론에 특화된 플랫폼이다. 아트레이데스매니지먼트·인덱스벤처스·TCV 주도로 15억 달러를 투자유치해 기업가치 175억 달러를 인정받았고, ARR은 10억 달러를 넘어섰다.
투게더AI(Together AI)는 오픈소스 모델을 값싸게 돌려주는 ‘AI 네이티브 클라우드’를 표방한다. 사우디 아람코 벤처스 주도로 8억 달러 시리즈C를 유치했고 기업가치는 83억 달러다.
모달랩스(Modal Labs)는 추론뿐 아니라 샌드박스·학습까지 아우르는 서버리스 컴퓨트 플랫폼이다. 액셀 주도로 7억5천만 달러 시리즈D를 투자유치했고, 액셀은 심플리스마트의 기존 투자자이기도 하다.
제너럴 컴퓨트(General Compute)는 추론 전용 칩을 담보로 하는 네오클라우드로, 1억 달러 시리즈A를 투자유치했다.
경쟁사에 대한 자세한 내용은 여기를 참고하시길.
심플리스마트의 차별점: 서빙 설정과 용량 운영을 소프트웨어로 푼다
심플리스마트는 규모 경쟁 대신 세 가지를 내세운다.
첫째, 지표 하나가 아니라 워크로드의 요구 조건을 기준으로 구성한다. 에마 사례처럼 지연 시간과 단가가 모두 목표 안에 들어오는 설정을 찾는 방식이다. 회사는 추론을 “순위표가 아니라 스펙트럼”이라고 설명한다.
둘째, GPU를 직접 보유하지 않고 서드파티 GPU 위에서 돌아가는 소프트웨어만 제공한다. 그래서 클라우드 사업자가 이를 자사 브랜드의 관리형 AI 서비스로 내놓을 수 있다. 요타의 서버리스 추론이 이런 구조다. 투게더AI나 제너럴 컴퓨트처럼 자체 클라우드를 운영하는 모델과 갈리는 지점이다.
셋째, 배포 위치에 대한 통제권을 유지한다. 회사는 특정 클라우드 안에서든 온프레미스든 모델을 돌릴 수 있고, 주권·데이터 상주 요건을 맞춰야 하는 기업·정부 수요를 겨냥한다. GPU 한 장 대신 일부만 할당하는 방식으로 비용을 낮춘 엑소텔 사례도 이 연장선이다.
다만 세 가지는 모두 회사가 밝힌 포지셔닝이다. 베이스텐·파이어웍스AI 같은 경쟁사도 전용 배포와 맞춤 최적화를 제공하는 만큼 차별점의 폭은 향후 고객 수와 수치로 검증돼야 한다. 조달 규모도 1,400만 달러로, 수억~수십억 달러를 모은 경쟁사와는 자릿수가 다르다.
주요 AI 기업들의 투자 관계망에 대한 자세한 내용은 여기를 참고하시길.
- Accel
- AI
- AI Infra
- Dallas Venture Capital
- funding
- Inference
- Micromax
- Nvidia
- Overseas funding
- seriesB
- Shastra VC
- Simplismart
기사 공유하기

답글 남기기
댓글을 달기 위해서는 로그인해야합니다.